Há dois anos, pouco depois de Richard Ho ter entrado para a OpenAI como vice-presidente de hardware, viajou até à Ásia com o CEO da empresa, Sam Altman, e um grupo de investigadores para se reunirem com os maiores fabricantes de chips do mundo: TSMC, Samsung e SK Hynix.
A mensagem de Altman foi direta. A procura de capacidade de computação por parte da OpenAI, já então insaciável, iria continuar a crescer, e a indústria dos semicondutores teria de acelerar o ritmo — e muito. “Olhem, daqui a alguns anos vamos precisar de muito mais silício. Por favor, comecem a construir mais fábricas”, recorda Ho ter ouvido de Altman.
Essas empresas construíram, de facto, mais fábricas de semicondutores, as instalações onde os chips são fisicamente produzidos. Mas não foi suficiente para satisfazer a procura aparentemente inesgotável da OpenAI, explica Ho à Forbes. Foi, em parte, devido a esta escassez que a empresa decidiu desenvolver o seu próprio hardware, cabendo a Altman confiar a Ho a tarefa de criar uma equipa de raiz.
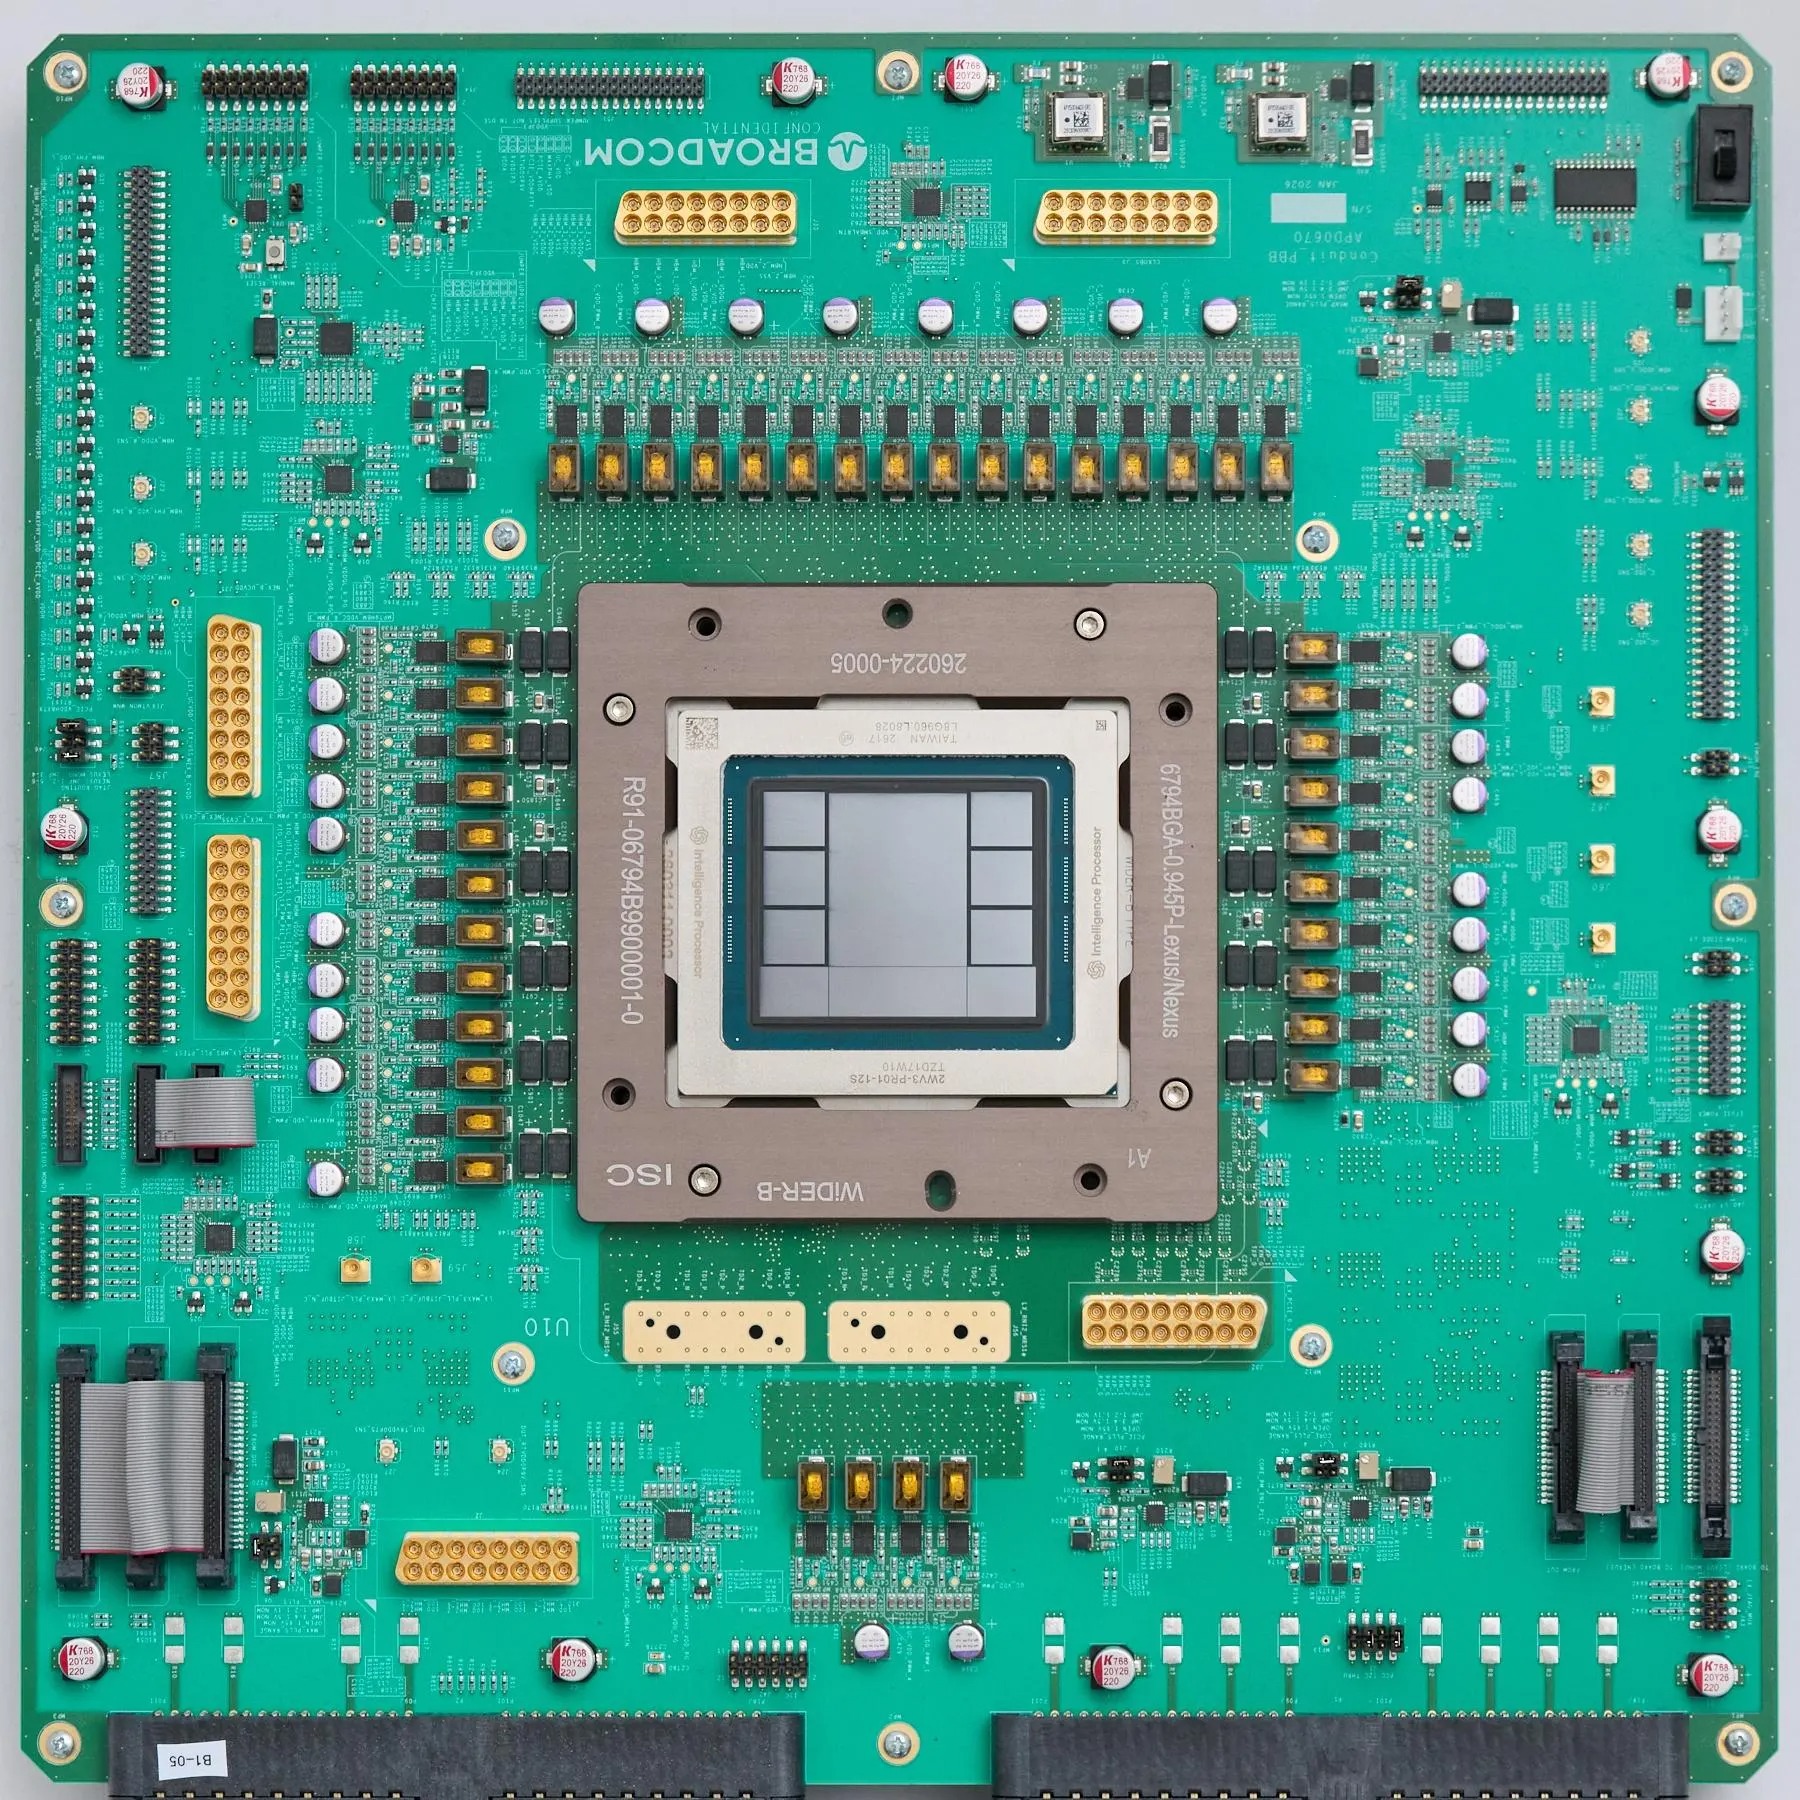
Dois anos depois, a empresa anunciou o seu primeiro semicondutor, um chip de inferência chamado Jalapeno. Em junho, a OpenAI revelou ter desenvolvido o chip em nove meses e anunciou que pretende começar a instalá-lo nos centros de dados até ao final do ano.
“Uma das limitações com que nos deparamos agora é que, se tivéssemos começado a construir [mais fábricas] há cerca de dois anos e meio, estaríamos numa posição muito melhor”, afirma Ho à Forbes.
Antes de entrar para a OpenAI, Ho, um veterano da Google, ajudou a conceber o primeiro chip TPU da gigante das pesquisas, um semicondutor desenvolvido especificamente para aplicações de inteligência artificial.
Numa extensa entrevista à Forbes, falou sobre a criação da equipa, a escolha da Broadcom como parceira no desenvolvimento dos semicondutores, em detrimento de empresas como a Nvidia e a AMD, e a forma como o debate sobre os riscos existenciais da inteligência artificial também chegou ao seu trabalho de desenvolvimento de chips. A entrevista foi editada para efeitos de extensão e clareza.
Começo por uma pergunta simples: porque é que o chip se chama Jalapeno?
Richard Ho: Não nos levamos demasiado a sério. Temos uma zona com molhos picantes na cafetaria do escritório, e a nossa equipa está sempre a ir lá. A nossa equipa chama-se, na verdade, Hot Peppers. Escolhemos esse nome para nós próprios. Por isso, pareceu natural dar ao nosso dispositivo e ao nosso projeto o nome de algo de que gostamos: comida picante.
Porque é que a OpenAI precisa de desenvolver um chip próprio?
Penso que se trata, essencialmente, de controlar toda a infraestrutura tecnológica. A OpenAI tem os modelos e faz um bom trabalho nessa área, além de dispor da camada de software que permite levar a informação dos modelos até aos chips, que, até agora, têm sido sobretudo unidades de processamento gráfico, ou GPU.
Se conseguirmos controlar toda esta cadeia, teremos a capacidade de fazer mais e de fazer melhor. Se controlarmos os centros de dados, os chips, os sistemas em que estes são integrados, os modelos e o software, poderemos operar de forma mais eficiente.
Em vez de existirem interfaces muito rígidas entre cada camada, poderemos combiná-las e reorganizá-las para melhorar a eficiência. Isso acaba por permitir disponibilizar mais inteligência ao utilizador, consumindo menos energia. Esta é a nossa principal métrica: quanta inteligência conseguimos fornecer por cada watt de energia consumido?
Desenvolver um chip próprio é um processo dispendioso e exigente. Pode explicar como surgiu a ideia? Como foram essas conversas e o que lhe disse Sam Altman?
As minhas primeiras conversas com ele foram essencialmente sobre se queríamos desenvolver o nosso próprio dispositivo. Não era uma decisão tomada à partida. Tratava-se de analisar as opções. Poderíamos obter o que precisávamos pedindo aos fornecedores existentes — AMD, Nvidia e Intel — que desenvolvessem algo à nossa medida? Acontece que, por trabalharem para um mercado muito abrangente, era bastante difícil conseguir exatamente aquilo que pretendíamos. Além disso, tinham arquiteturas antigas que precisavam de preservar.
Depois de fazermos uma análise imparcial das opções, concluímos que, se começássemos do zero a conceber um chip para esta finalidade, conseguiríamos uma eficiência muito superior à de qualquer solução construída sobre uma arquitetura anterior. Foi então que Sam nos deu luz verde para avançar.
A ideia era criar uma equipa pequena. Não iríamos construir uma equipa do tamanho da Intel ou sequer da Nvidia. Queríamos perceber se seria possível fazer algo com uma equipa pequena e de elite, utilizando a nossa própria inteligência artificial para acelerar o trabalho e obter bons resultados.
Quando começámos a falar sobre isto, no início de 2024, os modelos ainda não eram muito bons a trabalhar com hardware, para ser honesto. Tínhamos algumas dúvidas sobre os benefícios que poderiam trazer. Mas, ao longo dos meses seguintes e do ano que se seguiu, os modelos melhoraram significativamente, e conseguimos tirar muito partido deles para acelerar o desenvolvimento.
Referiu que se trata de uma equipa pequena. Qual é a sua dimensão?
Somos cerca de 100 pessoas. Durante o processo, a média esteve mais próxima das 70. [Em comparação, as equipas da Nvidia ou da Intel podem ter 500 ou mais pessoas.]
Mas não se trata apenas de especialistas em chips. A equipa trabalha em todo o sistema: conceção de bastidores, placas, alimentação elétrica, gestão térmica, cadeia de abastecimento e software. Se considerarmos apenas os profissionais dedicados aos chips, somos pelo menos duas ordens de grandeza menos do que uma equipa típica de desenvolvimento de semicondutores.
Quando fala em eficiência, quer dizer que o chip foi concebido especificamente para as vossas cargas de trabalho?
É um chip muito flexível e programável. Não foi concebido especificamente para os modelos da OpenAI. Pode executar praticamente qualquer modelo, e isso é importante porque os investigadores continuam a trabalhar e os modelos vão melhorando cada vez mais.
Precisamos de um sistema que consiga adaptar-se às mudanças introduzidas pelos investigadores. Assim, quando desenvolvermos modelos futuros, o hardware continuará a ser muito eficiente na sua execução. Esse foi um dos objetivos do projeto e penso que os resultados que apresentámos demonstram que o conseguimos alcançar.
Porque optaram por uma solução de inferência mais generalista? A OpenAI é uma empresa que consome enormes quantidades de capacidade de computação. Porque não desenvolver um chip mais ajustado às vossas necessidades específicas?
Aqui falo enquanto especialista em hardware. O desenvolvimento de hardware demora muito tempo. Dizemos que o nosso chip ficou pronto em nove meses, um dos processos mais rápidos — se não o mais rápido — demonstrados desde a fase inicial de conceção, ou mesmo sem existir qualquer projeto, até à produção de um dispositivo. Mas, no mundo da inteligência artificial, até nove meses é muito tempo. E ainda precisamos de tempo para instalar os chips nos centros de dados e colocá-los em funcionamento.
Por isso, qualquer hardware que desenvolvamos tem de ser adaptável e estar preparado para acompanhar os novos modelos e as novas ideias que surgem constantemente na investigação em inteligência artificial.
Enquanto especialista em hardware, considero extremamente arriscado criar uma solução demasiado específica. Isso obrigar-nos-ia a perguntar todas as semanas: qual é a investigação mais recente? Que artigo científico foi publicado? Conseguimos adaptar-nos?
Ao desenvolver um dispositivo mais programável e de utilização mais geral, temos a garantia de que conseguiremos acompanhar essa evolução. Ainda assim, o nosso chip é um pouco mais especializado do que uma GPU convencional, que é extremamente programável para todo o tipo de tarefas. O Jalapeno está otimizado para transformers e grandes modelos de linguagem, ou LLM. Dentro dessa categoria, deverá ser bastante adaptável. Para outras tarefas, poderá haver hardware mais adequado.
Tendo esta capacidade de inferência generalista, está nos planos vender os chips a outras empresas ou disponibilizá-los através de um serviço de computação na nuvem?
Não diria que essa possibilidade está excluída, mas temos tanta procura interna que ainda demoraremos algum tempo a satisfazer as nossas próprias necessidades. Como é um chip versátil, vale a pena discutir essa hipótese, mas não é algo em que estejamos focados neste momento.
Porque escolheram trabalhar com a Broadcom no desenvolvimento deste chip, em vez da Nvidia, da AMD ou da Marvell?
Todas são excelentes opções. Trabalharia com qualquer uma delas. No caso da Broadcom, realizámos um processo de avaliação dos parceiros bastante imparcial.
Um dos fatores importantes foi a propriedade intelectual analógica. Quando falamos de um acelerador, não estamos a falar apenas de um chip. Antigamente, quando falávamos de um computador pessoal, a questão central era o processador: qual era a sua qualidade e a sua capacidade de computação Hoje, na inteligência artificial, falamos de clusters, de supercomputadores enormes compostos por muitos chips interligados num bastidor e em vários bastidores, formando um sistema completo que executa estas tarefas.
Para isso, precisamos de muita comunicação entre os componentes e de memória muito avançada, que permita armazenar dados, aceder-lhes rapidamente e transferir grandes quantidades de informação com elevada velocidade.
A propriedade intelectual da Broadcom era, portanto, mais adequada às vossas necessidades do que a da Nvidia?
Os outros fornecedores também disponibilizam essa propriedade intelectual. Simplesmente, avaliámos as opções e concluímos que, no balanço global, a Broadcom era uma excelente escolha.
Também já tínhamos experiência com a empresa. Eu e muitos membros da minha equipa viemos da Google. Estive lá quando foi desenvolvido o primeiro TPU, e vários elementos da equipa atual fizeram parte dessa equipa original.
Durante o desenvolvimento do TPU, trabalhámos muito com a Broadcom. São, em parte, as mesmas pessoas. Se queríamos concretizar este projeto muito rapidamente, essa experiência prévia ajudava a facilitar o processo.
Referiu que um dos objetivos do desenvolvimento do chip era melhorar a eficiência dos custos. Os equipamentos da Nvidia são caros. Esta solução vai reduzir a dependência da OpenAI em relação à Nvidia?
Penso que a Nvidia continuará a fazer parte da nossa infraestrutura. O mais importante é que Sam compreendeu a visão para a capacidade de computação de que a OpenAI precisa. A procura é tão elevada que o nosso chip vai complementar as restantes soluções.
Continuamos a ser um parceiro muito importante da Nvidia. Temos contratos com a AMD, com a Cerebras e com muitas outras empresas. Onde se enquadra o Jalapeno? Na capacidade adicional que estamos a criar.
Como geriram a relação com a Nvidia, passando de clientes a desenvolver também os vossos próprios chips?
A forma como vejo a situação — e não sei se o [CEO] Jensen Huang ou a Nvidia a veem da mesma maneira — é que estamos a competir entre amigos.
Damos-lhes muito negócio e são um parceiro fundamental para nós. Mas, se conseguirmos fazer melhor e pressioná-los a melhorar, devemos fazê-lo, certo? É isso que estamos a dizer: já conseguimos fazer isto. Vocês também podem fazer melhor. E, se melhorarem, nós beneficiamos. Portanto, todos ganhamos.
Diria que existia muito ceticismo na indústria em relação à possibilidade de um laboratório de inteligência artificial desenvolver um chip de primeira geração pronto para produção. Tenho muito orgulho na equipa e no apoio que recebemos dentro da OpenAI para tornar isso possível.
Têm alguma estimativa de quanto dinheiro a OpenAI poderá poupar na próxima década graças a este chip?
Não fiz essa análise. Peço desculpa. Talvez possamos tentar voltar a falar consigo com uma resposta. É difícil apresentar uma estimativa neste momento.
[Num esclarecimento posterior por correio eletrónico, um porta-voz da OpenAI afirmou que a empresa não dispõe de uma estimativa.]
Qual é a maior diferença entre desenvolver chips para a Google e fazê-lo para a OpenAI?
Tive o privilégio de estar na Google e acompanhar o crescimento do TPU. A principal diferença que identifico é a proximidade que temos aqui com os investigadores e com a equipa de software, porque a OpenAI é uma empresa muito mais pequena.
Continuamos a trabalhar num ambiente muito semelhante ao de uma startup. O nível de interação e a troca constante de ideias são extraordinários. A visão de longo prazo de que precisamos mesmo desta infraestrutura — porque é uma questão existencial para a empresa — vem de Sam Altman e de Greg Brockman, cofundador e presidente da OpenAI. Isso levou toda a gente a trabalhar de forma muito próxima e a avançar rapidamente.
O Jalapeno é um chip de inferência. Desenvolveriam também um chip para treino de modelos?
O treino exige muita coisa. Não vale a pena iludirmo-nos: precisa de uma enorme capacidade de computação. Mas o crescimento que estamos a observar acontece sobretudo na inferência, e é aí que identificamos uma lacuna. Conseguir reduzir o custo da inferência ajuda todo o nosso portefólio de produtos. É por isso que estamos concentrados nesta área.
Especificamente para o pré-treino, não é uma hipótese excluída. Trata-se de definir prioridades e de começar pelas áreas que mais importam para a empresa e para os nossos utilizadores, avançando depois para as restantes. Portanto, não descartaria essa possibilidade, mas não estou focado nela neste momento.
A OpenAI afirmou que começaria a instalar o Jalapeno nos centros de dados até ao final do ano. Quando deverá entrar em produção plena?
O nosso objetivo é ter alguma coisa em produção durante o primeiro semestre de 2027. Nessa altura, alguns utilizadores poderão estar a utilizar o Jalapeno com determinados modelos. É uma meta ambiciosa, porque ainda há muito trabalho de software e outras tarefas de preparação a realizar.
De quantos gigawatts estamos a falar?
Não divulgámos essa informação publicamente.
Tem-se falado muito sobre os riscos existenciais da inteligência artificial e sobre uma possível desaceleração do desenvolvimento. Gostaria de perceber como é que esse debate influencia o vosso trabalho. Se houver uma desaceleração, isso afeta a forma como pensam os chips e a expansão dos centros de dados?
Este é um ponto extremamente importante. Considero que o debate é fundamental e que a empresa está muito empenhada em garantir a existência das orientações adequadas, das salvaguardas de segurança necessárias e de todos os mecanismos de monitorização de que precisamos. Isso é absolutamente essencial.
E, já agora, tudo isso exige muita capacidade de computação. A infraestrutura é aquilo que permite às pessoas fazer estas escolhas. Podemos decidir utilizar parte da capacidade disponível para reforçar a segurança, as salvaguardas e a monitorização. Ou podemos utilizá-la para fazer avançar os modelos. Penso que este equilíbrio deve ser definido ao nível das políticas da empresa.
Do nosso ponto de vista, a infraestrutura tem de continuar a tornar-se mais eficiente e a crescer. Vejo esta necessidade como algo que alarga as nossas próprias estimativas iniciais. Pensávamos precisar de determinada quantidade de capacidade de computação apenas para responder às necessidades dos utilizadores. Mas, se vamos implementar muito mais salvaguardas de segurança e mecanismos de monitorização, então também temos de acrescentar muita mais capacidade de computação para o conseguir, certo?
Texto original aqui. Artigo traduzido e editado por Paulo Marmé.